
Worst Case Analysis en baloncesto: EVA, RSS o Montecarlo
Cuando las entradas de un cálculo son inciertas, el Worst Case Analysis (WCA) ofrece tres métodos clásicos para saber entre qué valores acabará el resultado. Aquí se aplican al mismo problema, con respuesta conocida: dónde acaba cada equipo de Primera FEB. Esto es lo que se midió, qué aporta el modelo frente a lo más simple y qué no.
1 · Cómo se plantea el problema
Predecir dónde acabará un equipo es un problema de propagación de incertidumbre: el resultado final depende de muchas cosas inciertas (cuánto vale de verdad cada equipo, qué pasará en cada uno de los partidos que quedan) y lo que se busca no es un puesto, sino el rango de posiciones entre las que puede acabar y con qué probabilidad.
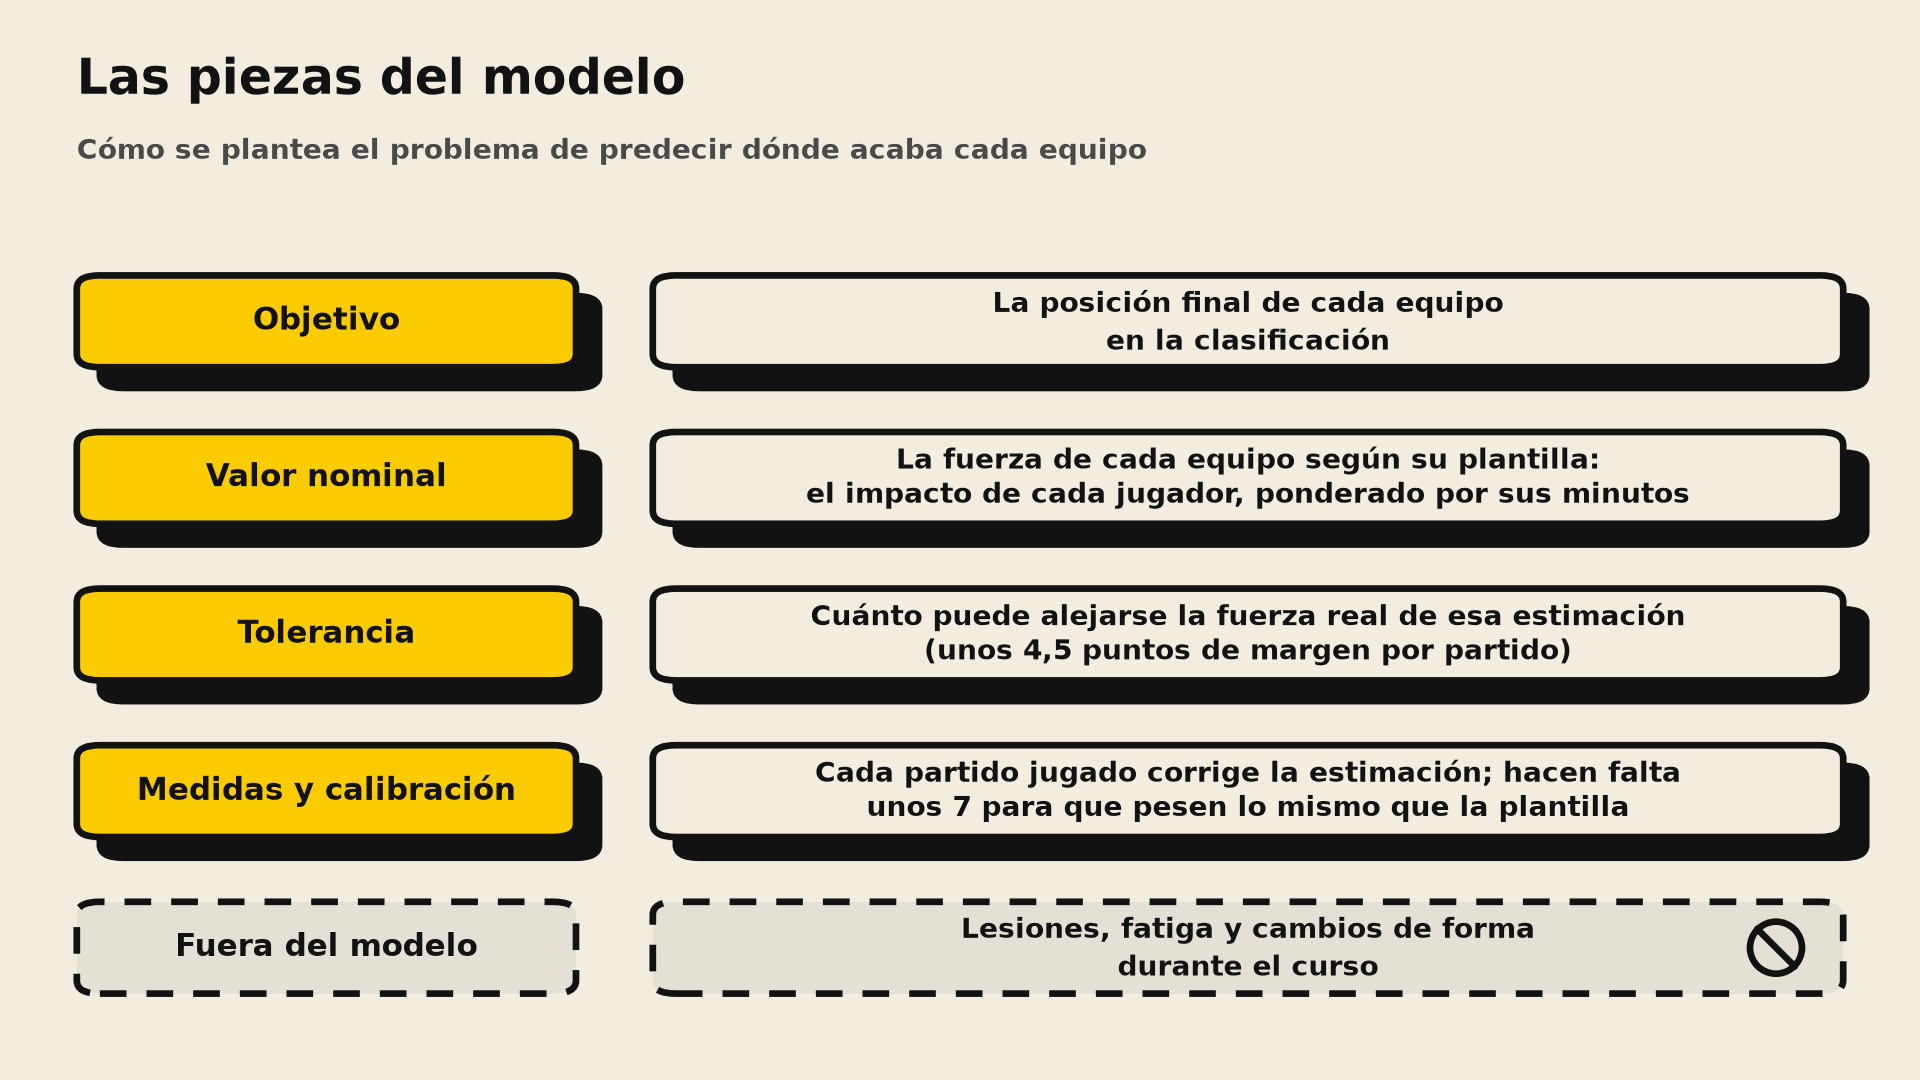
Hay dos niveles de azar: la fuerza real de cada equipo en esa temporada concreta (se sortea una vez por iteración y se mantiene) y el ruido de cada partido (cambia en cada uno). Lo que sale de repetir 50.000 veces no es un valor, sino la distribución del puesto final de cada equipo.
2 · El problema, y cómo se mide
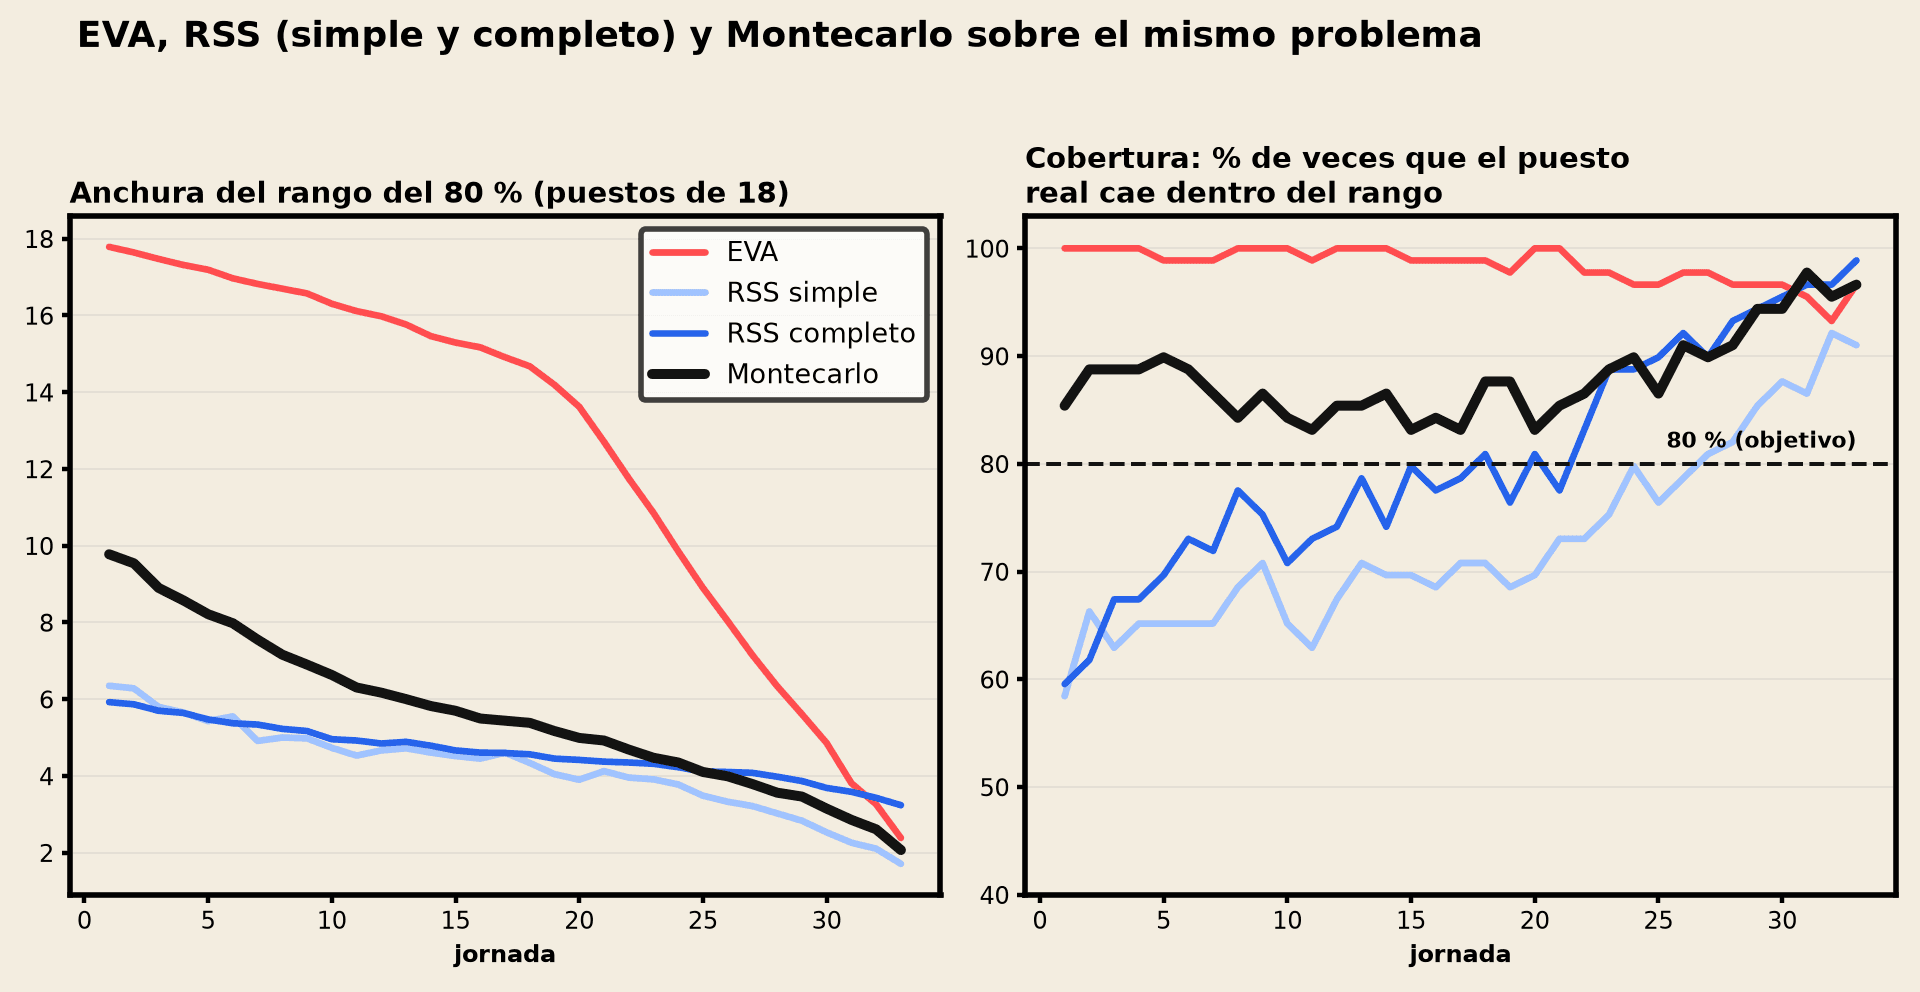
Tras una jornada, cada método da, para cada equipo, un rango de posiciones que debería contener su puesto final el 80 % de las veces. Se comprueba con las temporadas ya jugadas, usando solo lo que se sabía en cada momento. Se miden dos cosas:
- Cobertura: el porcentaje de veces que el puesto final real cae dentro del rango. Si el objetivo es el 80 %, debería ser en torno al 80 %.
- Anchura: cuántas posiciones abarca el rango (de las 18 de la clasificación). Cuanto más estrecho, más informa.
3 · Tres métodos, el mismo problema
Extreme Value Analysis: todas las tolerancias, a la vez, en el sentido que más perjudica; después, todas en el contrario. Cada partido que queda es una fuente de incertidumbre (una «tolerancia»): para el mejor puesto de un equipo, gana todos los suyos y en los demás gana quien más le conviene; para el peor, al revés. Es una garantía: cubre siempre.
Se suman en cuadratura las contribuciones de cada tolerancia, suponiéndolas independientes y su efecto lineal. En su versión simple solo cuenta la incertidumbre del propio equipo. En la completa se compara cada equipo con cada uno de los demás: se suma la incertidumbre de los dos, se tiene en cuenta que sus partidos directos les afectan al revés y se propaga la incertidumbre de la fuerza estimada con sensibilidades.
Se sortean todas las fuentes de incertidumbre según su distribución (50.000 temporadas simuladas tras cada jornada, con la misma fuerza de cada equipo que usa el RSS), se propaga por el modelo y se lee el 80 % central de la distribución del puesto final.
| Tras la jornada 3 | Tras la jornada 12 | Tras la jornada 20 | |
|---|---|---|---|
| EVA | ≈100 % · 17,5 | ≈100 % · 16,0 | ≈100 % · 13,6 |
| RSS simple | 63 % · 5,8 | 67 % · 4,7 | 70 % · 3,9 |
| RSS completo | 67 % · 5,7 | 74 % · 4,8 | 81 % · 4,4 |
| Montecarlo (50.000) | 89 % · 8,9 | 85 % · 6,2 | 83 % · 5,0 |
4 · ¿Y la información de entrada? Frente a una moneda trucada
Un Montecarlo no es mejor por serlo: es tan bueno como sus entradas. La segunda comparación es contra lo más simple que se podría hacer: tomar la clasificación real de hoy y el calendario real que queda, y decidir cada partido con una moneda trucada hacia el local. Todos los equipos son iguales salvo la ventaja de campo (el local gana en torno al 63-65 %). Es un Montecarlo sin información: sin plantilla previa y sin calibración con cada partido.
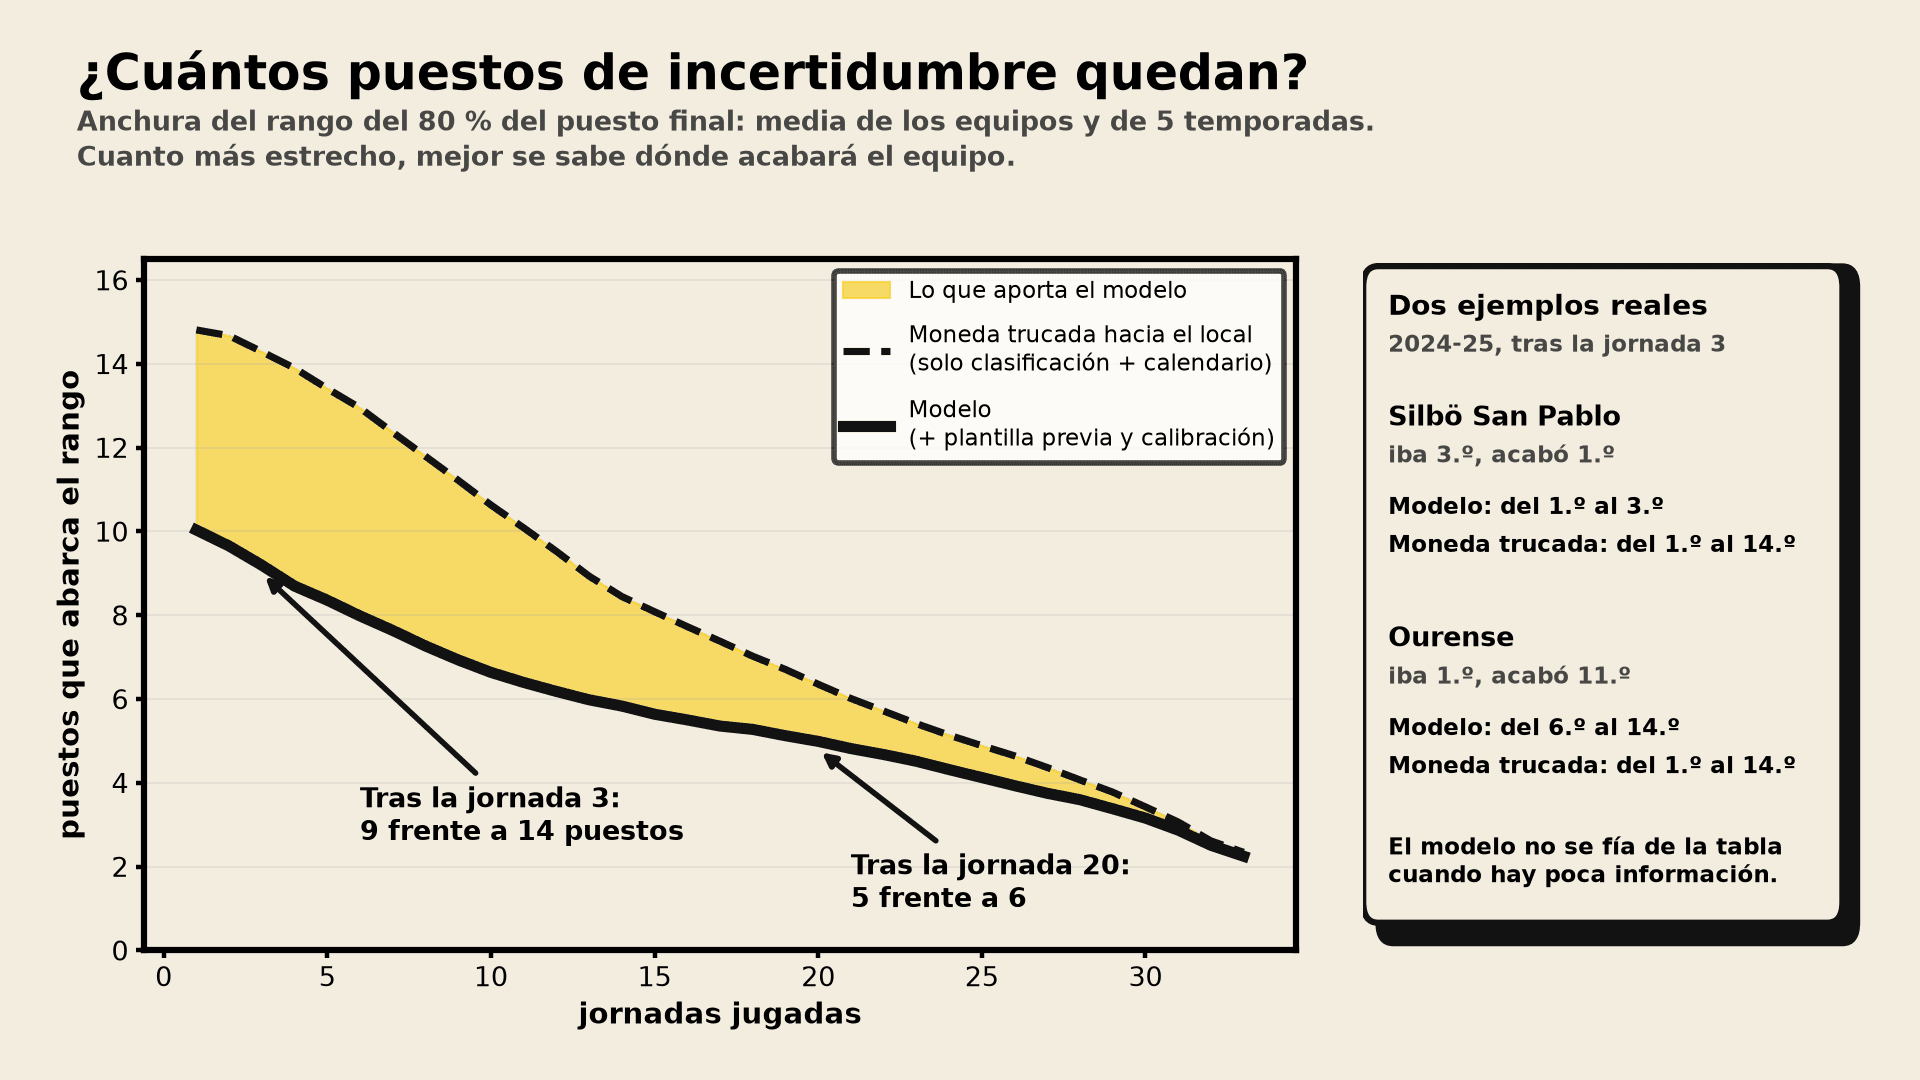
Tras la jornada 3, el rango del 80 % ocupa unos 9 puestos con el modelo y unos 14 con la moneda trucada, y el error de las probabilidades de zona (Brier) es un 20 % menor. La plantilla de cada club dice algo cuando casi no hay partidos.
El cono de la moneda trucada se cierra solo, porque quedan menos partidos que puedan cambiar algo. Tras la jornada 20 son 5 puestos frente a 6 y la mejora del Brier baja al 6 %: la clasificación ya contiene casi todo lo que hay que saber.
2024-25, tras la jornada 3. Silbö San Pablo (iba 3.º, acabó 1.º): el modelo lo situaba entre el 1.º y el 3.º, la moneda trucada entre el 1.º y el 14.º. Ourense (iba 1.º, acabó 11.º): el modelo, entre el 6.º y el 14.º. No se fía de la tabla cuando hay poca información.
Es lo que ocurre cuando una sola variable domina el resultado: el método simple y el Montecarlo dan lo mismo. El Montecarlo aporta donde hay poca información y mucha incertidumbre. Se puede ver, equipo a equipo y temporada a temporada, en Liga → Simulación → «Cómo ha cambiado».
5 · ¿Está bien calibrado? ¿Hay fugas?
- Calibración. Cuando el modelo daba entre un 80 y un 95 % de que algo ocurriera, ocurría en torno al 85 % de las veces. Entre el 60 y el 80 % tiende a ser algo demasiado seguro: decía 70 y ocurría el 61.
- Fuga de información. En una temporada cerrada, la previa de plantilla podría «ver el futuro» (los fichajes de enero). Rehecha con solo los jugadores que ya habían pisado la pista en cada momento, el Brier es de 0,0768 frente a 0,0770: no hay fuga.
- Partido a partido. Con lo que se sabía antes de cada jornada, el ganador se acierta en el 74,8 % de 1.117 partidos (de la jornada 3 en adelante), con un error medio del margen de 9,3 puntos. Dar siempre ganador al local acierta el 62 %. En las dos primeras jornadas de cada temporada el modelo empata con «gana el local» (58,6 % frente al 57,5 % en 87 partidos): casi no hay medidas.
- Optimismo. Los parámetros se ajustaron con esas mismas temporadas, así que las cifras son algo optimistas. La prueba limpia es la temporada en curso (2026-27: 36 partidos hasta ahora, 64 % frente al 61 % del local, una muestra aún pequeña). Se actualiza en Liga → Previa → «Cómo acertó el modelo».
6 · Lo que se probó y no movió el resultado
De unas veinte ideas, casi todas no mejoraron la predicción de forma fiable, y eso es un resultado. La razón es de observabilidad: no se calibra lo que no se puede medir. Un partido es un instrumento con un ruido de 12 puntos para parámetros cuya tolerancia es de 1 o 2. Esos parámetros se quedan como tolerancia y se propaga su incertidumbre; comprobar que la salida no se mueve es un análisis de sensibilidad.
- Ausencias con cola. Un jugador de rotación falta a uno de cada 18 partidos, y si no vuelve la ausencia dura hasta el final (datos censurados: la ausencia sigue abierta cuando acaba la temporada). Metido el proceso entero en la simulación, ninguna probabilidad se mueve más de 1,5 puntos porcentuales.
- Envejecimiento, continuidad, ruido y ventaja de local propios de cada equipo, ritmo, descanso, viajes: nada fiable.
- Valorar mejor a los fichajes de fuera de la liga. Incluso conociendo de antemano lo que valdría cada uno, el log-loss de los partidos solo mejora 0,005 y nada en las primeras jornadas.
- Más peso a los partidos recientes. En partidos, ninguna mejora fiable; en la simulación de la liga, un 2-3 % con solo cuatro temporadas y parte lograda igual ensanchando la incertidumbre.
- Encoger las probabilidades de las dos primeras jornadas. Mejora en cuatro temporadas, pero el intervalo incluye el 0 y 2026-27 va en contra: no se aplica.
7 · Lecciones aprendidas
Si hace falta una garantía, EVA, a costa de sobredimensionar. RSS es rápido y útil cuando el efecto es una suma, y peligroso si la salida no es lineal o hay correlaciones. Montecarlo, cuando la salida es compleja y sus distribuciones de entrada están validadas.
Frente a la moneda trucada, el Montecarlo gana mucho al principio y casi nada al final. Saber dónde NO aporta es parte del resultado.
Parámetros ajustados con los mismos datos con que se valida y una posible fuga de información que hay que descartar midiéndola. La prueba limpia es la temporada en curso.
Se probaron pesos por antigüedad, edad, descanso, ausencias, ruido por equipo y otra valoración de los fichajes. Ninguno mejoró de forma fiable, así que ninguno entró en el modelo (ver «Lo que se probó y no movió el resultado»).
8 · Verlo en directo
La simulación de la liga, con la probabilidad de cada puesto de cada equipo, el recorrido de la predicción jornada a jornada y estos mismos gráficos, está en Liga → Simulación. La comparación partido a partido, con la calibración y las mayores sorpresas, en Liga → Previa → «Cómo acertó el modelo».
Ver tambiénCalidad de los datos · Los datos: de la FEB a Delta Lake · El contenido: de las tablas a la tarjeta y al vídeo